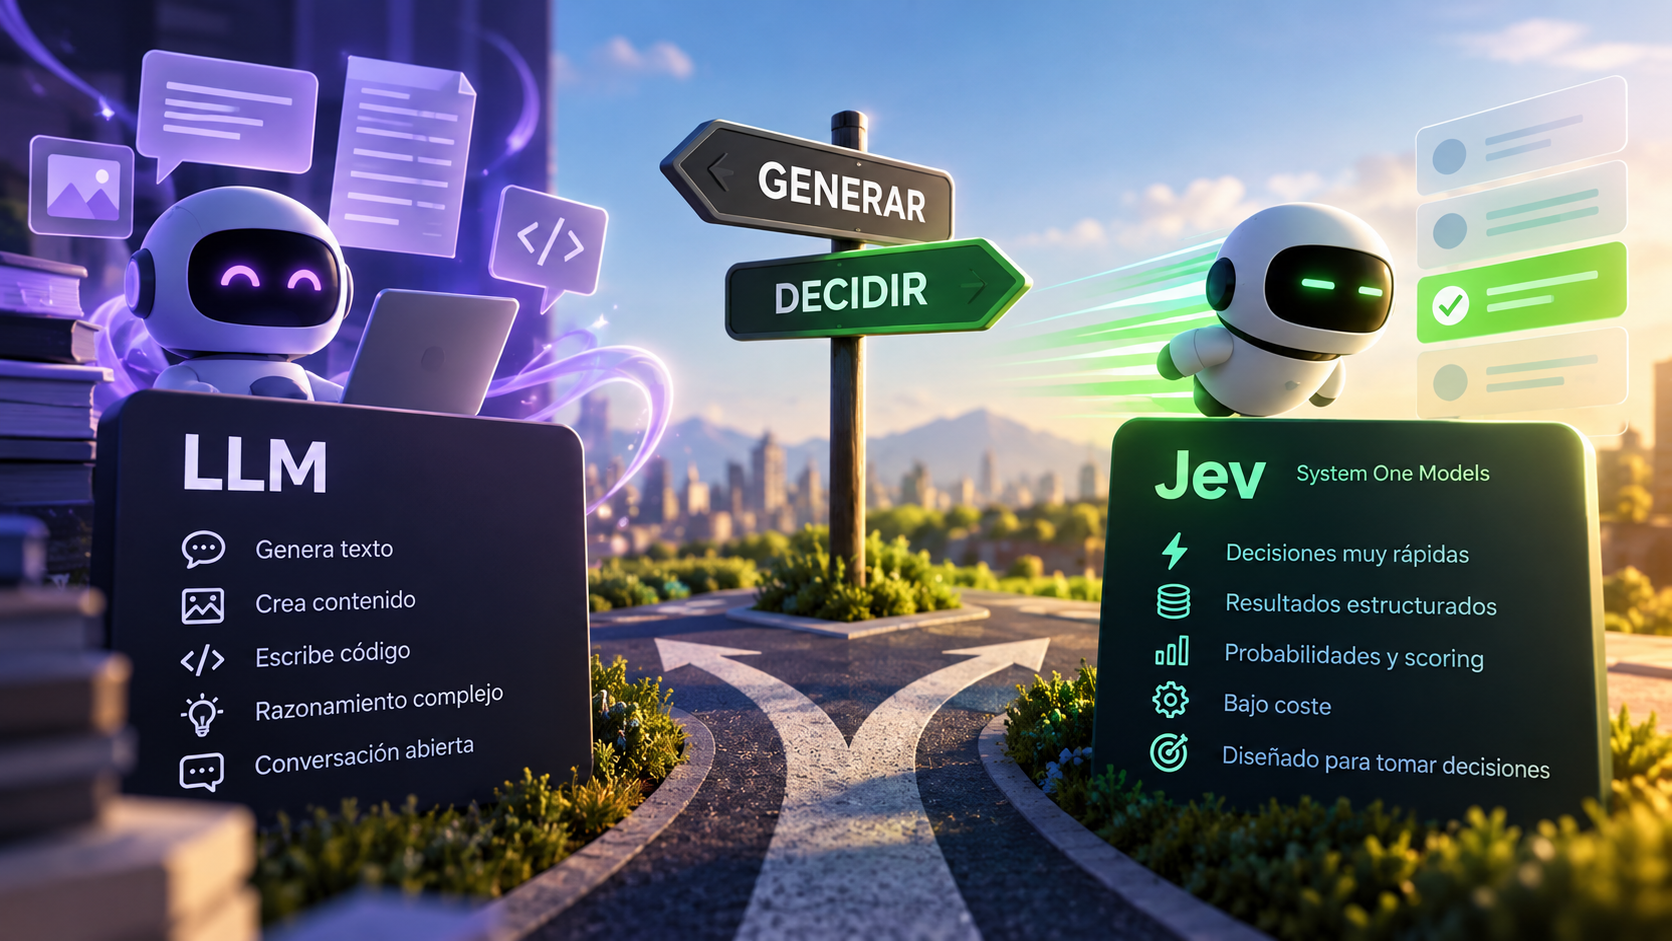
Llevamos un tiempo en el que parece que cualquier problema relacionado con interpretar lenguaje natural se resuelve de la misma forma: llamamos a un LLM, le pasamos un prompt y le pedimos que nos devuelva un JSON. Si necesitamos clasificar un correo, hacemos eso. Si queremos priorizar una incidencia, también. Si hay que seleccionar a qué equipo enviar un ticket, más de lo mismo.
No digo que esté mal. De hecho, los modelos generativos actuales son perfectamente capaces de resolver muchas de estas tareas y disponen de mecanismos de salida estructurada bastante potentes. Pero hay una pregunta que creo que merece la pena hacerse:
¿Tiene sentido utilizar un modelo diseñado para generar lenguaje cuando lo único que necesitamos es tomar una decisión entre opciones conocidas?
Esta es, precisamente, la propuesta de Jev, el primer modelo público de una nueva familia que TypeSafe denomina System One Models.
En este post quiero contar qué es, por qué me parece interesante desde el punto de vista de arquitectura de software, qué limitaciones tiene y cómo podemos probarlo con una pequeña PoC que he desarrollado para compararlo con Claude Haiku y Sonnet.
¿Qué es Jev? ¿De dónde nace y quién está detrás?
El 15 de septiembre de 2026, TypeSafe AI presentó Jev, su primer modelo público de la familia System One Models.
La compañía está impulsada por Diogo Almeida, fundador de TypeSafe y antiguo investigador de OpenAI. La idea de partida, explicada en el anuncio de lanzamiento, es bastante sencilla: los modelos generativos han alcanzado un nivel extraordinario para conversar, escribir, programar o razonar, pero buena parte de la automatización empresarial necesita decisiones que puedan consumir otros programas, no textos que tenga que interpretar una persona.
De ahí nace una propuesta diferente: construir modelos especializados en recibir un contexto y responder preguntas bien definidas mediante resultados tipados.
El nombre System One hace referencia al Sistema 1 descrito por Daniel Kahneman en Thinking, Fast and Slow: una forma de pensamiento rápida e intuitiva, frente al Sistema 2, más deliberativo. La referencia sirve para entender la intención de TypeSafe, pero no significa que Jev reproduzca literalmente el funcionamiento de la cognición humana.
¿Y por qué Jev? Según TypeSafe, el nombre es un homenaje a William Stanley Jevons, conocido, entre otras cosas, por la paradoja que lleva su apellido: cuando una tecnología se vuelve más eficiente, su consumo total puede aumentar en lugar de reducirse. Aplicado a la IA, la hipótesis es que abaratar radicalmente cada decisión permitirá introducir inteligencia en muchos más procesos.
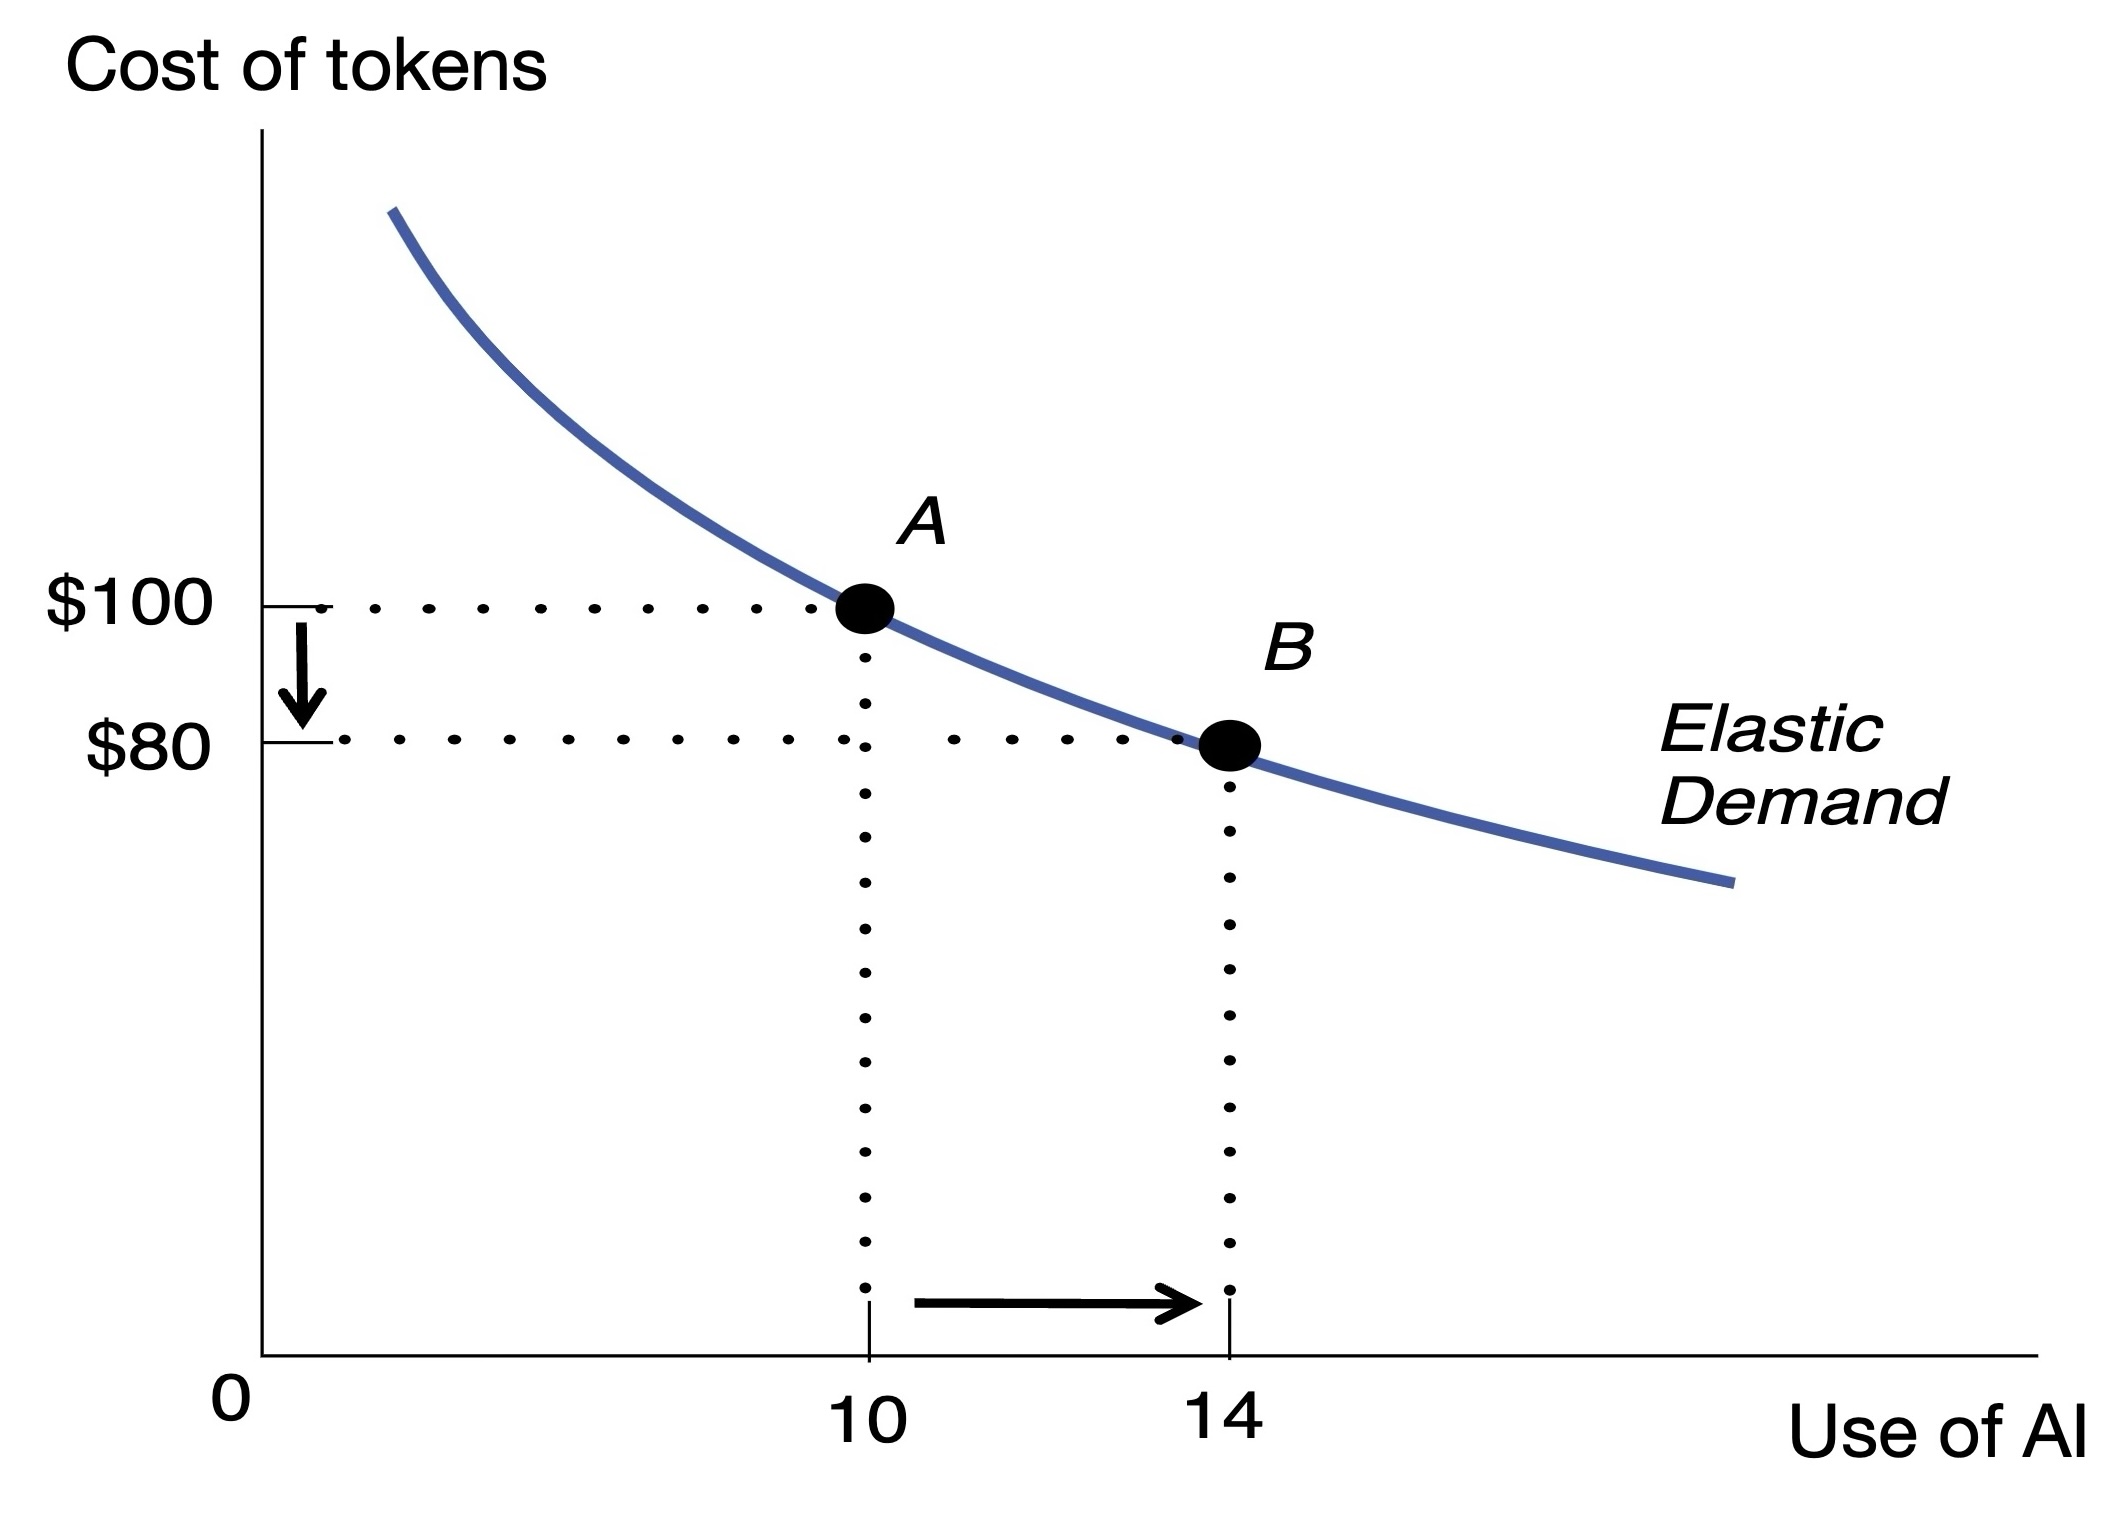
Creo que esta última idea es especialmente interesante: quizá no se trate solo de sustituir un LLM por algo más barato, sino de hacer viables decisiones que hoy ni siquiera nos planteamos automatizar.
¿Qué características tiene?
Para entender Jev hay que cambiar ligeramente la forma de pensar. En lugar de pedirle que «lea este texto y responda con un JSON», definimos dos elementos:
state: el contexto sobre el que queremos decidir. Puede contener texto o una estructura de datos.questions: las preguntas que debe resolver, con el tipo de respuesta y los criterios definidos previamente.
La aplicación establece el espacio de respuestas posibles; Jev evalúa el contexto y devuelve sus decisiones.
Tres primitivas: Choice, Score y Noul
La interfaz de System One se articula alrededor de tres primitivas:
| Primitiva | ¿Para qué sirve? | Ejemplo |
|---|---|---|
| Choice | Seleccionar una opción entre alternativas conocidas. | Clasificar un correo como SALES, SUPPORT, BILLING, SPAM u OTHER. |
| Score | Valorar un caso con una escala definida por el negocio. | Priorizar una incidencia de 0 a 4. |
| Noul | Evaluar cuánto respalda el contexto una proposición. | Detectar si una petición intenta saltarse una aprobación de despliegue. |
Podéis revisar el comportamiento y los campos de salida en la documentación oficial de System One.
Hay un detalle importante: Noul no es simplemente un booleano, sino una señal numérica que podemos interpretar mediante un umbral definido por nuestra aplicación. Igualmente, un Score puede ser continuo, aunque los criterios estén organizados por niveles.
Varias decisiones en una sola llamada
Otra característica especialmente útil es la posibilidad de plantear varias preguntas sobre el mismo contexto.
Imaginemos que recibimos esta alerta:
El servicio de pagos está caído para todos los clientes. Los logs muestran agotamiento del pool de conexiones de base de datos y no existen indicios de acceso no autorizado.
Podríamos solicitar, en una única petición, la prioridad (Score de 0 a 4), el riesgo de seguridad (Noul) y el equipo responsable (Choice entre BACKEND, PLATFORM y SECURITY). El resultado sería algo parecido a esto (ejemplo conceptual, no una respuesta real de la API):
{
  "priority": 4,
  "security_risk": 0.03,
  "team": "BACKEND"
}
Es decir, no necesitamos tres llamadas ni un texto explicativo para disponer de las tres decisiones. El código que consume el resultado puede determinar qué hacer después.
Respuestas tipadas, incertidumbre y eficiencia
TypeSafe pone el foco en otras tres características:
- Contrato de salida conocido: las preguntas y sus valores válidos están delimitados de antemano. Esto reduce los problemas de integración derivados de recibir respuestas que no respeten el contrato.
- Señales de incertidumbre: dependiendo de la primitiva, el modelo ofrece valores probabilísticos, distribuciones o confianza. No son garantías de acierto y deben validarse con datos reales.
- Optimización para decisiones: Jev no redacta una explicación palabra a palabra. Según sus creadores, esta diferencia permite reducir sustancialmente costes y tiempos de respuesta en las tareas para las que está diseñado.
En su presentación oficial, TypeSafe comunicó latencias orientativas de 70 a 500 ms y una tarifa pública de 0,042 USD por millón de tokens de entrada, sin coste de tokens de salida. Son cifras publicadas por el proveedor, no una promesa de rendimiento en cualquier entorno ni una tarifa contractual garantizada. Conviene comprobar las condiciones vigentes antes de presupuestar.
Un último matiz: garantizar que una respuesta respete el esquema no significa garantizar que la decisión sea correcta. Un clasificador puede devolver perfectamente BILLING cuando la categoría que esperábamos era OTHER.
¿Por qué es diferente de un LLM tradicional?
Un LLM generativo está diseñado para producir contenido; Jev está diseñado para emitir decisiones acotadas que otro software pueda utilizar directamente.
Esto no quiere decir que Claude, GPT o Gemini no puedan devolver resultados estructurados. Pueden hacerlo mediante herramientas, function calling o esquemas de salida. La diferencia es el objetivo nativo del modelo y su interfaz de interacción, no la imposibilidad de obtener JSON de un LLM.
| Aspecto | LLM generativo | Jev / System One |
|---|---|---|
| Propósito | Generar y transformar contenido; también tomar decisiones. | Tomar decisiones tipadas sobre un contexto. |
| Salida | Texto o estructuras condicionadas por un esquema. | Opciones, puntuaciones y evaluaciones de proposiciones. |
| Espacio de respuestas | Potencialmente abierto, aunque se puede restringir. | Definido previamente mediante las preguntas. |
| Justificación en lenguaje natural | Puede generar una explicación. | No genera explicaciones de su razonamiento. |
| Integración | Validación y tratamiento de la salida. | Contrato acotado y consumible por código; sigue necesitando validación de negocio. |
| Cuándo encaja mejor | Generación, síntesis, diseño, conversación y razonamiento abierto. | Clasificación, priorización, routing, verificación y decisiones delimitadas. |
La idea principal que tenemos que tener en mente es que Jev no tiene por qué competir frontalmente o sustituir a los LLM sino que una arquitectura real pueden ser perfectamente complementarios.
Por ejemplo, un LLM puede diseñar una solución, redactar una respuesta o sintetizar un documento mientras que Jev puede decidir qué flujo ejecutar, qué categoría corresponde o si conviene derivar una operación a revisión humana.
Esto me recuerda un principio de arquitectura bastante clásico: utilizar cada componente para aquello que hace mejor, evitando añadir capacidades que el problema no necesita.
Ojo: siempre que podamos utilizar mecanismos deterministas siempre deberíamos optar por utilizarlos. Más sencillos de implementar, depurar, probar y desplegar.
¿Para qué casos de uso puede ser una buena opción?
Creo que donde de verdad tiene potencial es en los escenarios que cumplen condiciones como estas:
- disponen de muchos eventos o entradas,
- necesitan tomar decisiones repetibles,
- tienen un espacio de respuesta conocido
- se busca reducir coste o latencia.
Dentro de estos condicionantes encontramos casos como:
-
Clasificación y routing: por ejemplo, determinar si un correo corresponde a facturación, soporte o ventas; enviar tickets al equipo correcto; clasificar solicitudes; o decidir qué modelo generativo usar para cada tarea.
-
Scoring y priorización: por ejemplo, valorar la madurez de oportunidades comerciales, ordenar incidencias según impacto y urgencia, o identificar solicitudes que merecen revisión prioritaria.
-
Guardrails semánticos: por ejemplo, detectar si una instrucción parece intentar saltarse una aprobación o incumplir una regla expresada en lenguaje natural. La detección sería una señal adicional; no reemplaza los controles deterministas de seguridad.
-
Verificación de contenido y flujos de agentes: por ejemplo, evaluar si una respuesta cumple determinados criterios o si debe escalarse a un humano; introducir puntos de decisión acotados en flujos más amplios.
-
Decisiones múltiples sobre un mismo evento: por ejemplo, ante una incidencia, determinar a la vez prioridad, riesgo de seguridad y equipo responsable.
Desde un punto de vista de arquitecto, para mí no deja de ser un componente/servicio de decisión semántica que convive con reglas de negocio, APIs, eventos y modelos generativos, que es necesario en escenarios en los que un if/else convencional se queda corto, pero un LLM completo parece excesivo.
Eso sí, no sustituye a las reglas deterministas cuando podemos expresar y verificar completamente la decisión mediante código.
¿Y dónde puede no encajar?
A veces, al analizar una tecnología nueva, nos centramos tanto en sus ventajas que dejamos de mirar el otro lado. En este caso creo que conviene ser especialmente cuidadosos. Por ejemplo:
- Generación de contenido
- Requisitos de explicabilidad
- Soberanía y control
- Decisiones de alto impacto con necesidad de supervision
Veamos estos escenarios con más detalle
Generación de contenido
Si necesitamos redactar un informe, desarrollar una arquitectura, explicar alternativas técnicas, programar, resumir un documento o mantener una conversación, Jev no es el modelo adecuado para producir ese artefacto.
Podría participar en decisiones del flujo, pero la generación seguiría correspondiendo a un LLM u otro sistema especializado.
Explicabilidad: ¿por qué ha elegido o decidido esa opción o resultado?
Jev no proporciona una explicación de por qué ha elegido una categoría o ha asignado una puntuación. Podemos obtener señales asociadas a la decisión, pero no una descripción verificable de su razonamiento interno.
Pensemos en un correo que Jev clasifica como BILLING cuando un analista lo consideraría OTHER. Podemos saber qué devolvió y compararlo con la etiqueta esperada. Lo que no podemos pedirle es que nos detalle cuáles fueron sus razones internas para escoger esa opción.
La explicabilidad asociada a la IA es un requisito de mucha importancia en determinados contextos por lo que es un punto a tener muy en cuenta.
Una alternativa: Jev decide y un LLM explica
Podemos plantear una arquitectura híbrida:
- Jev toma la decisión sobre el contexto disponible.
- La aplicación devuelve esa decisión al consumidor.
- Se publica un evento o se encola una tarea, identificada con el ID de la decisión.
- Un modelo generativo económico, como Claude Haiku, recibe el contexto, la decisión y las señales disponibles y elabora una justificación basada en las evidencias del texto.
- La explicación se almacena asociada a la decisión para consulta posterior.
La ventaja es que, si la explicación no es necesaria para continuar, podemos generarla de manera asíncrona y mantener fuera del camino crítico la latencia del segundo modelo.
Aquí la precisión importa: no eliminamos la latencia de la explicación; la desacoplamos de la latencia de la decisión. Además, incorporamos un coste adicional, una dependencia y la necesidad de gestionar colas, reintentos y errores.
Y existe una limitación todavía más importante: la justificación que redacte el LLM (ej: Haiku) sería una explicación posterior (post-hoc) no el razonamiento interno de Jev . Puede resultar útil para interpretar las evidencias y facilitar la revisión, pero también podría construir un argumento que no sea fiel al motivo real de la predicción.
Por eso, en procesos regulados o críticos que exijan una explicación validada antes de actuar, no podemos simplemente moverla a segundo plano y dar el requisito por resuelto.
Cuando necesitamos control absoluto del despliegue
Como he comentado anteriormente, en el momento en que estoy escribiendo el artículo, si necesitamos ejecutar el modelo sin conectividad externa, dentro de nuestra infraestructura o en una ubicación contractual concreta que TypeSafe no pueda ofrecer, Jev puede no cumplir los requisitos, independientemente de lo bien que clasifique.
Decisiones de alto impacto sin supervisión
Rechazar una candidatura, bloquear una cuenta, autorizar un pago o desplegar a producción son acciones con consecuencias importantes. Jev puede ayudar a evaluar señales, pero una puntuación alta no equivale a una garantía y nunca debería ser el único control de autorización.
Hablemos de la madurez…¿es usable en producción?
Jev es un producto muy reciente: su presentación pública se produjo en septiembre de 2026. Obviamente, no estamos hablando de una tecnología con años de adopción generalizada, sino de una propuesta que está evolucionando rápidamente.
Eso no significa que no pueda utilizarse en producción. TypeSafe ya ha publicado el caso de Jack & Jill, una plataforma de empleo que, según su propio testimonio, sustituyó un modelo Gemini por Jev en una etapa de matching de candidatos. El caso reporta un 88 % menos de coste y una reducción del tiempo de procesamiento manteniendo una calidad comparable en esa tarea. Es un caso de cliente publicado por el proveedor: interesante como referencia, pero no equivale a una certificación independiente ni implica que esos ahorros sean extrapolables a otros sistemas.
TypeSafe continúa publicando versiones y funcionalidades. Por ejemplo, en el anuncio de Jev 1.14 diferencia las capacidades que considera suficientemente probadas de otras experimentales, como determinadas opciones multimodales o de contexto extendido.
Pero…¿y el soporte empresarial?
Aquí hay un matiz que creo que merece un apartado propio, especialmente si estamos pensando en introducir Jev en una empresa grande y/o muy tradicional.
No podemos decir que TypeSafe no tenga soporte empresarial ya que dispone de una página específica para empresas con contacto comercial, capacidad para solicitar mayores límites de consumo y referencias a opciones como la retención cero de datos. Sin embargo, disponer de un canal comercial no equivale a tener confirmadas todas las garantías empresariales que exigiríamos antes de una adopción crítica:
- SLA contractual,
- soporte 24×7,
- tiempos de respuesta ante incidentes,
- despliegue privado,
- cumplimiento específico,
- portabilidad,
- compromisos de continuidad,
- …
Sí que es cierto que Typesafe se está moviendo en este ámbito. En el anuncio de su ronda de financiación del 9 de octubre de 2026, TypeSafe señala expresamente que añadirá más funcionalidades empresariales. Es una señal positiva de inversión y dirección de producto, pero también indica que la oferta continúa evolucionando y que saben que falta cierta madurez para un producto empresarial.
En mi opinion, en este momento, en un contexto empresarial, iría por utilizar Jev sin demasiadas reservas en una PoC controlada, pero condicionar el paso a producción crítica a una revisión comercial, legal, de seguridad y de operación. No basta con que el modelo sea rápido y acierte nuestro dataset.
Si falla el servicio un sábado por la noche, ¿a quién llamamos?, ¿qué tiempo de recuperación nos garantizan?, ¿qué hacemos si cambian las condiciones de la API?, ¿qué datos pueden tratar y en qué región? Esas respuestas deben estar por escrito, no inferirse de una página de marketing.
Mi lectura es que Jev merece ser evaluado para producción en casos acotados, pero exige especial atención a su madurez operativa y a las garantías contractuales.
Antes de adoptarlo para una función crítica, revisaría al menos:
- Calidad sobre nuestro dominio: dataset representativo, etiquetas revisadas y pruebas con entradas ambiguas y fuera de distribución.
- Versionado: fijar versiones cuando la estabilidad sea necesaria y repetir evaluaciones antes de migrar.
- Comportamiento ante fallos: timeouts, límites de consumo, circuit breakers y fallbacks.
- Seguridad y privacidad: clasificación de los datos enviados, residencia, retención y acuerdos de tratamiento.
- Observabilidad: tiempos, costes, errores técnicos, errores de decisión y evolución temporal.
- Control de negocio: umbrales, aprobaciones humanas y reglas deterministas antes de acciones de riesgo.
- Garantías del proveedor: SLA, soporte, límites y continuidad del servicio.
Conviene recordar que una decisión probabilística no debe convertirse automáticamente en una autorización. Si Jev indica que una acción parece segura, nuestro sistema sigue siendo responsable de comprobar permisos, políticas y restricciones.
Otro punto importante…¿está disponible como modelo nativo en los grandes proveedores?
En el momento en que estoy escribiendo este articulo, no he encontrado documentación oficial que confirme Jev como modelo seleccionable y administrado de forma nativa en Amazon, Google, Azure,…. Por tanto, no lo presentaría como una capacidad disponible en esas plataformas.
Si una organización quiere utilizarlo desde alguna de esas nubes, el escenario respaldado por la documentación pública es el consumo de la API de TypeSafe desde la aplicación. Cualquier acuerdo específico de despliegue privado o distribución mediante terceros debe confirmarse con el proveedor.
¿Y ejecutarlo localmente?
Tampoco he encontrado que se pueda ejecutar localmente. Esta limitación importa en organizaciones con requisitos estrictos de aislamiento, soberanía del dato o despliegue completamente on-premise.
En resumen: podemos desarrollar y desplegar nuestro software donde queramos, pero la inferencia de Jev, según la oferta pública documentada, depende del servicio de TypeSafe.
¿Y si no necesitáramos Jev? La alternativa del Machine Learning tradicional
Hasta ahora he comparado Jev con modelos generativos empujado por el hype de la IA Generativa pero no debemos olvidar que las capacidades que ofrece Jev ya estaban disponibles antes de la explosion de la IA Generativa.
La clasificación de texto, el scoring y la detección de anomalías existían mucho antes de ChatGPT. Y, dependiendo del contexto, es posible que no necesitemos ni Jev ni un LLM.
Pensemos en el caso de clasificar correos. Una alternativa clásica sería entrenar un modelo supervisado a partir de mensajes etiquetados. Podemos empezar con TF-IDF y regresión logística, pasar a un SVM, combinar embeddings con un clasificador o ajustar un modelo encoder como ModernBERT. No todos requieren la misma cantidad de datos, hardware o esfuerzo de operación.
Otra posibilidad es utilizar soluciones gestionadas: Amazon Comprehend Custom Classification permite entrenar clasificadores con categorías propias y Google Cloud Document AI Custom Classifier ofrece opciones de clasificación documental, desde modelos preentrenados hasta entrenamiento personalizado. En abierto, enfoques como SetFit permiten ajustar clasificadores con relativamente pocos ejemplos y modelos de embeddings.
La comparación, por tanto, no debería limitarse a Jev frente a un LLM:
| Alternativa | ¿Qué necesitamos? | Principal atractivo | Principal contrapartida |
|---|---|---|---|
| Reglas deterministas | Criterios que podamos expresar con exactitud. | Previsibilidad, auditoría y coste mínimo. | Manejan mal la ambigüedad del lenguaje. |
| ML clásico o encoder especializado | Datos representativos, normalmente etiquetados, y un proceso de entrenamiento y mantenimiento. | Inferencia eficiente, control del modelo y posibilidad de despliegue propio. | Coste inicial de datos, entrenamiento, evaluación y actualización. |
| Jev | Definir preguntas, criterios y validar los resultados sobre casos reales. | Prototipado rápido y decisiones tipadas sin entrenar un clasificador propio. | Dependencia del proveedor y restricciones de explicabilidad/despliegue. |
| LLM pequeño con salida estructurada | Prompt, esquema y evaluación. | Flexibilidad y ecosistema amplio sin entrenamiento inicial. | Coste y latencia por llamada, aunque dependen del modelo y del volumen. |
No hay un ganador universal. Si disponemos de millones de correos históricos bien etiquetados y las clases apenas cambian, un clasificador especializado desplegado en nuestra infraestructura podría ser una opción excelente. Si, por el contrario, estamos explorando un proceso nuevo, tenemos pocas etiquetas y necesitamos cambiar los criterios con frecuencia, Jev puede reducir muchísimo la fricción inicial.
Tampoco sería correcto afirmar que el ML tradicional es necesariamente más lento de desarrollar o más caro de operar en todos los escenarios. Hay herramientas AutoML, modelos preentrenados y enfoques few-shot que han reducido mucho esa barrera. Y hay modelos supervisados que permiten inspeccionar qué variables han influido en una predicción, aunque eso tampoco garantiza por sí solo una explicación causal.
En una comparativa rigurosa incluiría al menos un baseline determinista y un clasificador supervisado, además de Jev y un LLM. Mi repositorio no incluye aún esas alternativas, por lo que no atribuiré a Jev ventajas frente a ellas basándome en las gráficas de la PoC.
¿Qué están haciendo OpenAI, Anthropic y otros proveedores?
La propuesta de TypeSafe resulta interesante, pero no aparece en el vacío. La industria está avanzando hacia resultados cada vez más estructurados, modelos más pequeños y servicios especializados, aunque no todos siguen el mismo camino.
Aquí conviene distinguir dos movimientos que, aunque están relacionados, no son lo mismo: conseguir que un modelo generativo respete un esquema y ofrecer una API pensada específicamente para tomar decisiones.
Alternativas que ya existían antes de Jev: structured outputs
OpenAI presentó Structured Outputs el 6 de agosto de 2024, más de dos años antes de la aparición pública de Jev. Antes incluso existían mecanismos como function calling o el modo JSON. Esta capacidad permite restringir las respuestas de un modelo generativo para que respeten un esquema JSON. Por ejemplo, podemos pedirle que clasifique un correo y devuelva un campo category cuyo valor pertenezca a un conjunto de opciones.
Es muy útil para integrar LLM en aplicaciones, pero no implica que estemos utilizando un modelo especializado en decisiones: seguimos trabajando con un modelo generativo, aunque hayamos delimitado la estructura de su respuesta.
Anthropic, por su parte, también ya ofrece Structured Outputs y strict tool use para producir objetos tipados y llamadas a herramientas que respeten contratos.
OpenAI Decisions API y GPT-6 Luna
El movimiento más interesante es mucho más reciente. Según el registro oficial de cambios de OpenAI, el 6 de octubre de 2026 se lanzó en beta la Decisions API con el modelo gpt-6-luna.
Decisions API es una interfaz específica para evaluar entradas y devolver decisiones tipadas, con preguntas acotadas. Su planteamiento se parece bastante más al de System One de TypeSafe.
La correspondencia entre conceptos resulta llamativa:
| TypeSafe Jev | OpenAI Decisions API | Para qué sirve |
|---|---|---|
Choice |
choice |
Seleccionar una alternativa entre opciones conocidas. |
Score |
score |
Asignar una puntuación según criterios. |
Noul |
predicate |
Evaluar cuánto respalda el contexto una condición. |
Además, el la forma de invocación es similar a la de System One: hay que indicar el modelo, las entradas y las preguntas/instrucciones. Por ejemplo (de la misma doc de OpenAI):
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON
Las dos propuestas permiten trabajar con decisiones acotadas y múltiples preguntas sobre un contexto. La documentación de OpenAI describe además decisiones sobre texto e imágenes y señales de probabilidad o confianza en determinados tipos de respuesta.
OpenAI afirma que esta API puede ser aproximadamente diez veces más rápida que utilizar su Responses API para este tipo de tareas. Hay que interpretar bien esa cifra: es una comparación publicada por OpenAI frente a otra API propia, no una medición independiente contra Jev. Tampoco podemos concluir de ella que Luna sea más preciso, más rápido o más barato que Jev en nuestro escenario concreto.
Por cierto, el artículo OpenAI Decisions API vs. Jev, de OrcaRouter es una referencia interesante para profundizar en esta comparación.
Aquí sí creo que podemos hablar de una alternativa directa al enfoque de Jev, aunque con un matiz: se trata de una API en beta y todavía necesitamos pruebas representativas para comparar su comportamiento real.
¿Y el resto del mercado?
No todas las alternativas siguen ese enfoque específico de Choice, Score o Predicate:
- AWS lleva tiempo ofreciendo clasificación mediante Amazon Comprehend, sin necesidad de resolver la tarea mediante un LLM generativo.
- Google Cloud dispone de Document AI Custom Classifier, orientado a clasificar documentos mediante servicios especializados.
- En el ecosistema abierto, ModernBERT y enfoques como SetFit ofrecen otra posibilidad: adaptar y desplegar clasificadores bajo nuestro control, con sus propias necesidades de datos, entrenamiento y mantenimiento.
Estas opciones no son equivalentes exactos de Jev ni de Decisions API. Pero refuerzan algo que ya comentaba en el apartado anterior: cuando el problema es clasificar, puntuar o decidir, hay que comparar más cosas que un LLM generativo.
Este tipo de movimientos refuerzan el trabajo de arquitectura a la hora de diseñar soluciones: ¿qué necesitamos realmente: un clasificador tradicional entrenado con nuestros datos, un LLM con salida estructurada o una API de decisiones como Jev o Decisions API? La respuesta dependerá de calidad, coste, latencia, explicabilidad, privacidad, madurez y posibilidades de despliegue.
Manos a la obra: Jev Decision Lab
Como me suele pasar cuando descubro algo interesante, llega un momento en el que leer documentación no me parece suficiente y quiero probarlo.
Para eso he preparado Jev Decision Lab, una PoC que compara Jev con Claude Haiku y Claude Sonnet sobre un conjunto de situaciones donde podemos medir resultados.
No pretende ser un benchmark universal ni demostrar que Jev gana siempre. Su objetivo es más práctico: ver cuándo una decisión acotada puede resolverse sin recurrir a un modelo generativo generalista, y qué sucede con la calidad, el coste y el tiempo de respuesta.
Casos de uso implementados
Dentro de la PoC he implementado estos casos de uso
| Caso de uso | Qué probamos | Tipo de decisión |
|---|---|---|
| Intelligent Model Routing | Elegir qué modelo utilizar para una tarea de software. | Choice |
| Intelligent Lead Scoring | Evaluar la madurez de una oportunidad comercial. | Score |
| Semantic Guardrails | Detectar peticiones que intentan omitir una aprobación. | Noul |
| Email Classification | Clasificar correos de negocio, incluido el spam. | Choice |
| Incident Prioritization | Asignar prioridad a incidencias operativas. | Score |
| Incident Triage | Obtener prioridad, riesgo de seguridad y equipo responsable a la vez. | Score + Noul + Choice |
| Architecture Decision & Planning | Diseñar y justificar una arquitectura. | Solo generativos |
El último caso es deliberado: también quiero enseñar dónde Jev no es la herramienta adecuada.
Dos formas de experimentar
En la PoC hay dos modos de uso:
- Playground, donde podemos introducir nuestro propio texto, seleccionar proveedores y comparar una ejecución individual.
- Test Scenarios, donde podemos ejecutar baterías repetidas sobre un dataset de referencias. La versión del proyecto que utilizo incluye 30 escenarios por caso de uso (210 en total), permite seleccionar proveedores, repetir las pruebas y subir un dataset JSON propio, que se valida antes de iniciar el proceso.
La aplicación compara:
- Acierto frente a la referencia definida para cada escenario.
- Decisiones incorrectas, diferenciándolas de los errores técnicos de API.
- Latencia observada de las llamadas.
- Consumo y coste estimado según las tarifas configuradas.
En el caso de diseño de arquitectura, el resultado requiere revisión cualitativa: no tendría sentido fingir una métrica de acierto binaria para un diseño abierto.
Importante: las etiquetas del dataset son ejemplos preparados para la PoC, no un conjunto de verdad terreno revisado de forma independiente. Un 95 % de coincidencia con estas etiquetas no equivale a «95 % de precisión en producción». Los costes son estimaciones, y el rendimiento depende también de la red y de los servicios externos.
¿Cómo ejecutarlo?
El proyecto utiliza Angular, FastAPI y Docker Compose. Necesitaremos las credenciales de TypeSafe y Anthropic para hacer llamadas reales a los proveedores:
git clone https://github.com/jaruizes/jev-use-cases.git
cd jev-use-cases
cp .env.example .env
# Configurar TYPESAFE_API_KEY y ANTHROPIC_API_KEY
docker compose up --build -d
Una vez levantado, podremos acceder a la aplicación en http://localhost:4200.
En el repositorio está el README con las instrucciones completas, la descripción de los casos y los detalles de implementación.
Os animo especialmente a probar correos ambiguos y situaciones de incidentes con prioridades difíciles de distinguir. Ahí es donde un porcentaje global pierde interés y empiezan a aparecer las preguntas útiles: ¿en qué se equivoca cada modelo?, ¿cuándo conviene exigir revisión humana?, ¿cuánto cuesta cada decisión correcta?
Conclusiones
Después de revisar la propuesta de TypeSafe y desarrollar la PoC, me quedo con varias ideas.
1. No toda necesidad de IA requiere generación: como suele pasar cuando hay hype, hemos normalizado utilizar LLM para cualquier entrada de lenguaje natural, pero hay problemas cuyo resultado es simplemente una decisión entre opciones conocidas. Merece la pena distinguir ambos escenarios.
2. Latencia y coste son ventajas potenciales pero no garantías en todos los escenarios: los datos publicados por TypeSafe llaman la atención y justifican probarlo pero, la decisión de arquitectura tiene que estar basada en los requisitos del escenario, del propio dataset de información que manejemos, de las latencias y nuestros criterios de calidad requeridos .
3. La explicabilidad es un punto clave: podemos pedir a otro modelo que elabore una justificación, incluso de forma asíncrona, pero eso no convierte la explicación en el razonamiento verificable de Jev. En determinados contextos, esta diferencia marca el “go” o “no go” a Jev.
4. La madurez, el soporte empresarial y el modelo de despliegue cuentan: es cierto que hay casos reales en producción ya con Jev pero es una herramienta reciente que depende de la oferta de TypeSafe. Para organizaciones con requisitos estrictos de soberanía, operación o continuidad, el análisis no termina en la precisión del modelo o de las características indicadas por el fabricante en su web sino que también es necesario disponer de características de uso empresarial sólidas.
5. No olvidemos el ML tradicional: un buen clasificador supervisado, o incluso reglas convencionales, puede ser la solución más razonable. Antes de introducir otra API deberíamos medir también esas opciones.
En lugar de preguntarnos «¿qué LLM utilizamos para resolver este problema?», deberíamos empezar preguntándonos «¿qué tipo de inteligencia necesita realmente este proceso?».
Si necesitamos generar, explicar o diseñar, un LLM tiene mucho sentido. Si necesitamos clasificar, priorizar o decidir dentro de límites definidos, propuestas como Jev abren una alternativa que merece ser explorada.
Referencias
- TypeSafe AI — Introducing System One Models & Jev.
- TypeSafe — Documentación de System One.
- TypeSafe AI — Jev 1.14 y características experimentales.
- TypeSafe AI — Caso de uso de Jack & Jill en producción.
- TypeSafe AI — Información para empresas.
- TypeSafe AI — Estado del servicio.
- TypeSafe — Anuncio de financiación y hoja de ruta empresarial (9 de octubre de 2026).
- OpenAI — Structured Outputs.
- Anthropic — Structured Outputs y uso estricto de herramientas.
- AWS — Amazon Comprehend Custom Classification.
- Google Cloud — Document AI Custom Classifier.
- Hugging Face — SetFit.
- Hugging Face — ModernBERT.